Безперервність та стійкість інформаційних систем
Матеріал підготовлений на основі виступу керівника IT-підрозділу Shadow Speaker на «NG-CISO» (Next Generation CISO)
Забезпечення безперервності та стійкості інформаційних систем базується на чотирьох взаємопов’язаних елементах: політиці управління оновленнями (систематичне виявлення та усунення вразливостей), плані безперервності бізнесу (комплексна проактивна стратегія), плані відновлення після інцидентів (документовані процедури відновлення IT-інфраструктури) та регулярному тестуванні (валідація через вправи та симуляції). Ці елементи є критично важливими як окремо, так і в синергії — лише працюючи як єдина система, вони забезпечують ефективний захист організації.
Політика управління оновленнями
Принципи та життєвий цикл
Управління оновленнями базується на таких принципах: циклічність процесу, ризикоорієнтований підхід, прозорість і підзвітність, автоматизація та сумісність.
Життєвий цикл включає послідовні етапи: виявлення (моніторинг через vendor bulletins, CVE бази), оцінка (аналіз CVSS score, впливу на бізнес, сумісності), планування та тестування (розробка графіку, тестування в ізольованому середовищі, підготовка rollback плану), розгортання (поетапне впровадження з моніторингом) та перевірка і контроль (верифікація, документування, аналіз метрик MTTP).
Нормативні вимоги та практичні виклики
Міжнародні стандарти встановлюють чіткі вимоги. ISO/IEC 27001 фокусується на контролях безпеки, NIST SP 800-40 надає практичні рекомендації для архітектури патч-менеджменту, CIS Control 7 вимагає безперервного виявлення через сканери та інтеграції з SIEM/SOAR. В Україні Закон про кібербезпеку вимагає системного документованого патч-менеджменту для об’єктів КІІ.
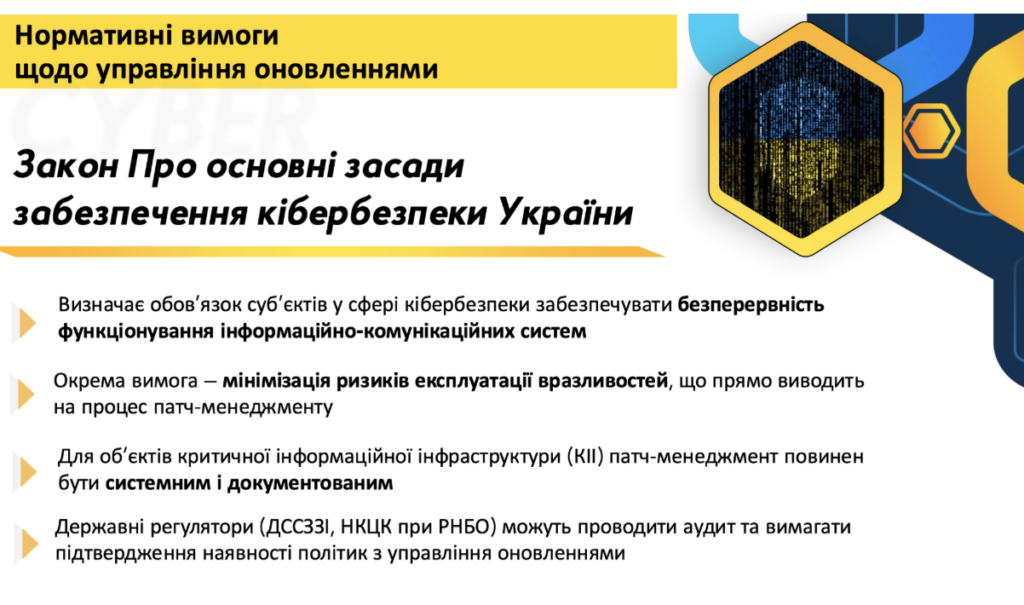
Найбільшим практичним викликом є балансування між швидкістю впровадження патчів безпеки та ризиком порушення стабільності. Оновлення функціоналу може призвести до повної зупинки використання системи, тому автоматизація не завжди можлива через складність реалізації та потенційний вплив на виробничі процеси. Ефективне управління оновленнями створює фундамент для наступного критичного елемента — забезпечення безперервності бізнесу.
План безперервності бізнесу (BCP)
Актуальність та аналіз впливу
Актуальність BCP визначається множинними факторами: кіберзагрози нового покоління (AI-enhanced Ransomware, APT-групи, Supply chain атаки), фізичні загрози в умовах війни (знищення дата-центрів, атаки на енергоінфраструктуру), регуляторні вимоги (ISO 27001, NIST Framework, GDPR) та ризики (фінансові втрати, втрата довіри клієнтів, санкції).
Аналіз впливу на бізнес (BIA) є фундаментом BCP. Процес включає інвентаризацію активів з документуванням залежностей, класифікацію за критичністю (Рівень 1: ERP, платежі — RTO 1–4 години; Рівень 2: email, файлові сервери — RTO 8–24 години; Рівень 3: аналітика — RTO 48–72 години) та розрахунок фінансових втрат за формулою: Втрати = Дохід/год × Час + SLA + Відновлення + Репутація.
RTO, RPO та фізичні загрози
Recovery Time Objective (RTO) визначає максимальний допустимий час простою. Критично важливі системи (платіжні) вимагають RTO 0–1 години через кластери Active-Active та синхронну реплікацію. Критично важливі для бізнесу (ERP, CRM) — RTO 1–4 години з Active-Passive кластерами. Важливі системи (email) — RTO 4–24 години через планове резервне копіювання.
Recovery Point Objective (RPO) визначає допустиму втрату даних. Нульова втрата (RPO: 0 хвилин) досягається через синхронну реплікацію на географічно розподілені сайти. Майже нульова (RPO: 1–15 хвилин) — асинхронна реплікація з системами CDP. Низький рівень (RPO: 15 хвилин — 4 години) — заплановані знімки та хмарні служби.
В умовах війни особливої уваги потребують регуляторні аспекти (воєнний стан, мобілізація), прямі загрози (пошкодження ДЦ — рішення: географічне розподілення; руйнування комунікацій — рішення: кілька провайдерів, супутниковий інтернет) та непрямі наслідки (енергетика — рішення: UPS, генератори).
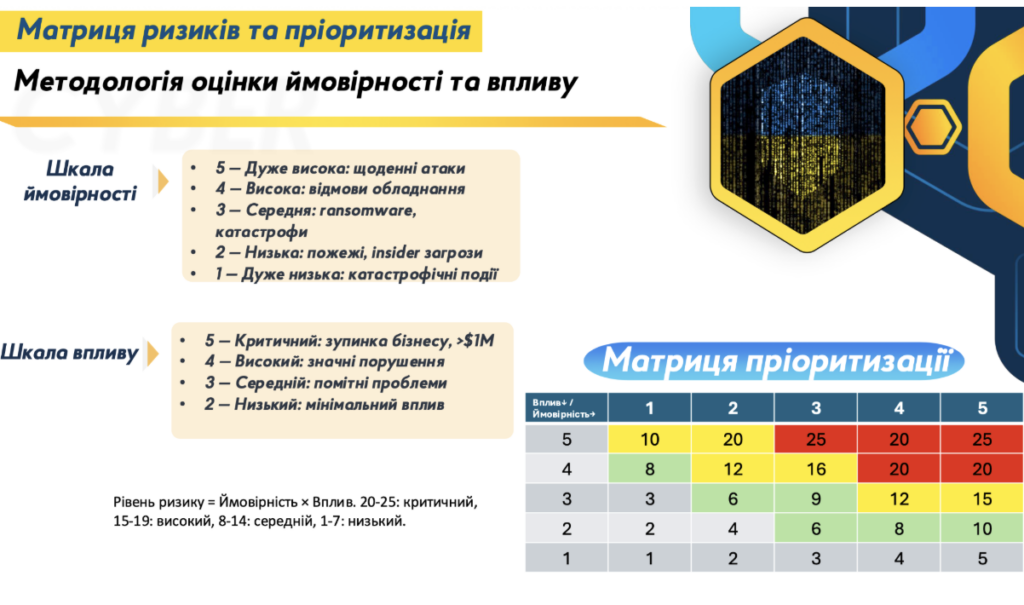
Визначивши стратегію безперервності, організація має підготувати конкретний план дій для швидкого відновлення після інцидентів різного характеру.
План відновлення після інцидентів (DRP)
Основні поняття та типи резервних майданчиків
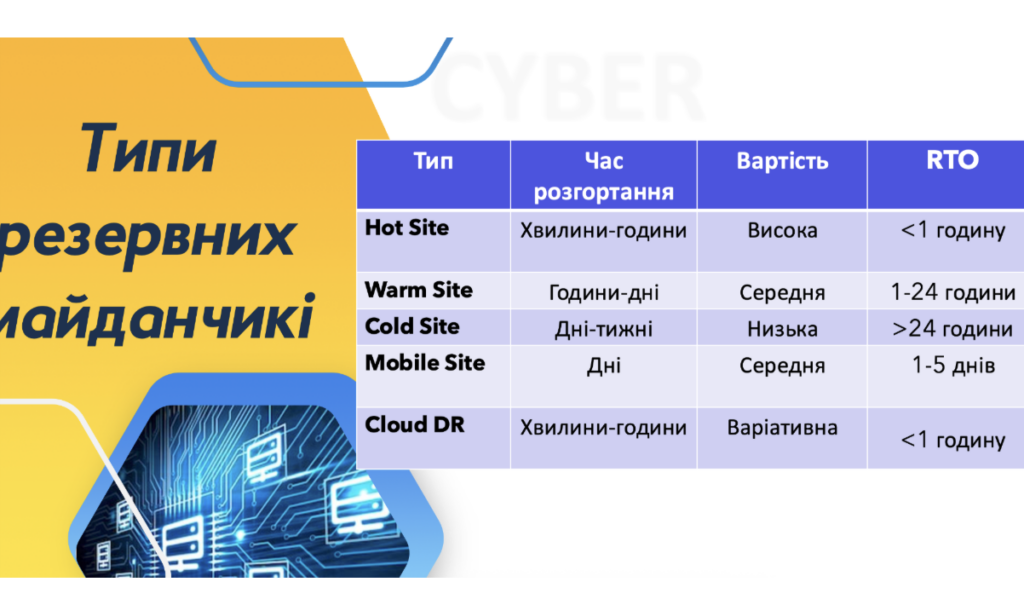
DRP охоплює відновлення після природних катастроф (повені, пожежі), техногенних загроз (кібератаки, збої обладнання) та соціальних факторів (страйки, пандемії). Ключові поняття: RTO (максимальний час простою), RPO (максимальна втрата даних), RLA (угода про рівень відновлення).
Типи резервних майданчиків різняться за швидкістю та вартістю.
Структура команди та стратегії відновлення
Команда DRP включає: керівника відновлення (координація, критичні рішення), IT-команду (відновлення систем, даних, обладнання), команду зв’язку (інформування співробітників, ЗМІ, клієнтів) та групу безпеки (фізична безпека, контроль доступу).
Стратегії відновлення даних реалізуються через резервне копіювання (повне, інкрементальне, диференціальне), правило 3-2-1 (3 копії, на 2 носіях, 1 поза офісом) та хмарні рішення. Критично важливою є холодна копія — резервна копія, фізично відключена від мережі. Як зазначив лектор, найзахищеніша система — відключена від інтернету та ізольована від користувачів.
Процес активації та тестування
Активація DRP проходить чотири фази: Фаза 1 (0-15 хв) — виявлення інциденту, підтвердження, оповіщення команди. Фаза 2 (15-30 хв) — оцінка масштабів, рішення про активацію, мобілізація ресурсів. Фаза 3 (30 хв – RTO) — розгортання резервних систем, відновлення даних, тестування. Фаза 4 — поступовий перехід на основні системи, аналіз, оновлення планів.
Тестування відбувається на трьох рівнях: настільні вправи (теоретичне обговорення, мінімальні витрати), симуляційне тестування (імітація реальних умов, виявлення проблем), повне тестування (реальна активація, найдостовірніші результати, високі витрати). Рекомендована частота: щокварталу для критичних систем, щорічно для інших.
Однак навіть найдосконаліші плани стикаються з викликами при впровадженні, які необхідно передбачити та мінімізувати.
Виклики та найкращі практики
Основні виклики
Впровадження стикається з організаційними викликами (недостатня підтримка керівництва, обмежений бюджет, опір персоналу), технічними складнощами (складність інфраструктури, проблеми інтеграції, застарілі технології) та управлінськими проблемами (недостатня документація, відсутність регулярного тестування).
Щодо персоналу — універсальних стандартів підрахунку необхідної кількості фахівців немає. Організації базуються на внутрішніх регламентах вендорів або власному досвіді, враховуючи специфіку систем та необхідність забезпечення заміни (наприклад, 3 адміністратори на систему).
Інтеграція політики управління оновленнями, плану безперервності бізнесу та плану відновлення після інцидентів створює комплексну систему цифрової стійкості, яка дозволяє організації не лише пережити кризу, а й швидко відновитися з мінімальними втратами. В умовах зростаючих кіберзагроз та фізичних ризиків це стає обов’язковою умовою виживання та конкурентоспроможності бізнесу.
Матеріал підготовлений на основі виступу керівника IT-підрозділу Shadow Speaker на «NG-CISO» (Next Generation CISO)
Забезпечення безперервності та стійкості інформаційних систем базується на чотирьох взаємопов’язаних елементах: політиці управління оновленнями (систематичне виявлення та усунення вразливостей), плані безперервності бізнесу (комплексна проактивна стратегія), плані відновлення після інцидентів (документовані процедури відновлення IT-інфраструктури) та регулярному тестуванні (валідація через вправи та симуляції). Ці елементи є критично важливими як окремо, так і в синергії — лише працюючи як єдина система, вони забезпечують ефективний захист організації.
Політика управління оновленнями
Принципи та життєвий цикл
Управління оновленнями базується на таких принципах: циклічність процесу, ризикоорієнтований підхід, прозорість і підзвітність, автоматизація та сумісність.
Життєвий цикл включає послідовні етапи: виявлення (моніторинг через vendor bulletins, CVE бази), оцінка (аналіз CVSS score, впливу на бізнес, сумісності), планування та тестування (розробка графіку, тестування в ізольованому середовищі, підготовка rollback плану), розгортання (поетапне впровадження з моніторингом) та перевірка і контроль (верифікація, документування, аналіз метрик MTTP).
Нормативні вимоги та практичні виклики
Міжнародні стандарти встановлюють чіткі вимоги. ISO/IEC 27001 фокусується на контролях безпеки, NIST SP 800-40 надає практичні рекомендації для архітектури патч-менеджменту, CIS Control 7 вимагає безперервного виявлення через сканери та інтеграції з SIEM/SOAR. В Україні Закон про кібербезпеку вимагає системного документованого патч-менеджменту для об’єктів КІІ.
Найбільшим практичним викликом є балансування між швидкістю впровадження патчів безпеки та ризиком порушення стабільності. Оновлення функціоналу може призвести до повної зупинки використання системи, тому автоматизація не завжди можлива через складність реалізації та потенційний вплив на виробничі процеси. Ефективне управління оновленнями створює фундамент для наступного критичного елемента — забезпечення безперервності бізнесу.
План безперервності бізнесу (BCP)
Актуальність та аналіз впливу
Актуальність BCP визначається множинними факторами: кіберзагрози нового покоління (AI-enhanced Ransomware, APT-групи, Supply chain атаки), фізичні загрози в умовах війни (знищення дата-центрів, атаки на енергоінфраструктуру), регуляторні вимоги (ISO 27001, NIST Framework, GDPR) та ризики (фінансові втрати, втрата довіри клієнтів, санкції).
Аналіз впливу на бізнес (BIA) є фундаментом BCP. Процес включає інвентаризацію активів з документуванням залежностей, класифікацію за критичністю (Рівень 1: ERP, платежі — RTO 1–4 години; Рівень 2: email, файлові сервери — RTO 8–24 години; Рівень 3: аналітика — RTO 48–72 години) та розрахунок фінансових втрат за формулою: Втрати = Дохід/год × Час + SLA + Відновлення + Репутація.
RTO, RPO та фізичні загрози
Recovery Time Objective (RTO) визначає максимальний допустимий час простою. Критично важливі системи (платіжні) вимагають RTO 0–1 години через кластери Active-Active та синхронну реплікацію. Критично важливі для бізнесу (ERP, CRM) — RTO 1–4 години з Active-Passive кластерами. Важливі системи (email) — RTO 4–24 години через планове резервне копіювання.
Recovery Point Objective (RPO) визначає допустиму втрату даних. Нульова втрата (RPO: 0 хвилин) досягається через синхронну реплікацію на географічно розподілені сайти. Майже нульова (RPO: 1–15 хвилин) — асинхронна реплікація з системами CDP. Низький рівень (RPO: 15 хвилин — 4 години) — заплановані знімки та хмарні служби.
В умовах війни особливої уваги потребують регуляторні аспекти (воєнний стан, мобілізація), прямі загрози (пошкодження ДЦ — рішення: географічне розподілення; руйнування комунікацій — рішення: кілька провайдерів, супутниковий інтернет) та непрямі наслідки (енергетика — рішення: UPS, генератори).
Визначивши стратегію безперервності, організація має підготувати конкретний план дій для швидкого відновлення після інцидентів різного характеру.
План відновлення після інцидентів (DRP)
Основні поняття та типи резервних майданчиків
DRP охоплює відновлення після природних катастроф (повені, пожежі), техногенних загроз (кібератаки, збої обладнання) та соціальних факторів (страйки, пандемії). Ключові поняття: RTO (максимальний час простою), RPO (максимальна втрата даних), RLA (угода про рівень відновлення).
Типи резервних майданчиків різняться за швидкістю та вартістю.
Структура команди та стратегії відновлення
Команда DRP включає: керівника відновлення (координація, критичні рішення), IT-команду (відновлення систем, даних, обладнання), команду зв’язку (інформування співробітників, ЗМІ, клієнтів) та групу безпеки (фізична безпека, контроль доступу).
Стратегії відновлення даних реалізуються через резервне копіювання (повне, інкрементальне, диференціальне), правило 3-2-1 (3 копії, на 2 носіях, 1 поза офісом) та хмарні рішення. Критично важливою є холодна копія — резервна копія, фізично відключена від мережі. Як зазначив лектор, найзахищеніша система — відключена від інтернету та ізольована від користувачів.
Процес активації та тестування
Активація DRP проходить чотири фази: Фаза 1 (0-15 хв) — виявлення інциденту, підтвердження, оповіщення команди. Фаза 2 (15-30 хв) — оцінка масштабів, рішення про активацію, мобілізація ресурсів. Фаза 3 (30 хв – RTO) — розгортання резервних систем, відновлення даних, тестування. Фаза 4 — поступовий перехід на основні системи, аналіз, оновлення планів.
Тестування відбувається на трьох рівнях: настільні вправи (теоретичне обговорення, мінімальні витрати), симуляційне тестування (імітація реальних умов, виявлення проблем), повне тестування (реальна активація, найдостовірніші результати, високі витрати). Рекомендована частота: щокварталу для критичних систем, щорічно для інших.
Однак навіть найдосконаліші плани стикаються з викликами при впровадженні, які необхідно передбачити та мінімізувати.
Виклики та найкращі практики
Основні виклики
Впровадження стикається з організаційними викликами (недостатня підтримка керівництва, обмежений бюджет, опір персоналу), технічними складнощами (складність інфраструктури, проблеми інтеграції, застарілі технології) та управлінськими проблемами (недостатня документація, відсутність регулярного тестування).
Щодо персоналу — універсальних стандартів підрахунку необхідної кількості фахівців немає. Організації базуються на внутрішніх регламентах вендорів або власному досвіді, враховуючи специфіку систем та необхідність забезпечення заміни (наприклад, 3 адміністратори на систему).
Інтеграція політики управління оновленнями, плану безперервності бізнесу та плану відновлення після інцидентів створює комплексну систему цифрової стійкості, яка дозволяє організації не лише пережити кризу, а й швидко відновитися з мінімальними втратами. В умовах зростаючих кіберзагроз та фізичних ризиків це стає обов’язковою умовою виживання та конкурентоспроможності бізнесу.
